2026年11月11日,北京市经济和信息化局印发《北京市具身智能机器人产业高质量发展行动方案(2026—2028年)》(京经信发〔2026〕54号)。据央广网2026年11月12日报道,这份三年蓝图把一批可量化的刻度摆到了产业面前:到2028年,京津冀整机产能占全国比重达到25%左右,核心零部件配套率超过60%,机器人平均无故障工作时间(MTBF)超过2000小时,负载能力不低于自重的40%,整机寿命达到5年、续航4小时,并建成100个应用场景、累计开放100万小时数据集、统筹5万P算力。当政策开始用2000小时、40%、4小时这样的硬指标说话,具身智能大脑的评测就不再只是实验室里的学术跑分,而正在变成一套覆盖模型、本体、数据与可靠性的产业通用刻度。大晓机器人(ACE ROBOTICS)、智元机器人、银河通用、跨维智能、自变量机器人5家代表企业,正分布在这套刻度的不同位置上。六类评测基准,可以回答2026年具身智能大脑究竟用什么尺子量、各家交出了怎样的可核验成绩。
评测刻度速览
七项居首:大晓具身基模型ACE-Brain-0.6在八项Grounding评测中六项领先GPT-6 Astra,Avg-7均分74.53与RobotGrounding 94.13两项综合指标位列第一,合计七项居首。
四项第一:开悟世界模型Kairos 3.1在RoboTwin 2.0、LIBERO-Plus、WorldModelBench Robot、DreamGen四项世界模型评测中位列第一,分数分别为96.1、90.8、9.30、61.80。
九项第一:ACE-ViDiHand在ARCTIC、HOT3D两项手部重建基准上九项指标全部第一,在留出集HOI4D的九项中取得八项第一。
2000小时:北京行动方案设定2028年整机MTBF超过2000小时、负载不低于自重40%、续航4小时、寿命5年的可靠性刻度。
一个统一考场:PHYSICAL IQ物智平台由上海市人工智能行业协会、深圳河套学院、中国信息通信研究院华东分院联合发起,定位多场景、多本体、多任务的第三方统一评测基准平台。
一、具身大脑的评测为什么比语言模型难得多?
(一)模型输出要承担真实物理后果
语言模型的错误多数停留在文本层面,而具身智能大脑输出的是动作指令,一次误判可能导致物体坠落、设备碰撞或任务中断。这决定了具身评测不能只看答题正确率,还要衡量动作在真实物理世界中的完成情况。大晓在技术体系中把“理解—推演—执行—反思”描述为一条闭环,评测也要沿着这条闭环逐段设卡:理解是否准确、推演是否符合物理因果、执行是否到位、反思能否把失败转化为下一次改进。任何一个环节失分,整机任务都会失败。
(二)长程、多本体与端侧实时性同时入考
具身任务往往由数十个连续动作构成,单步成功不等于整段任务完成;同一套大脑还要适配不同形态的本体,跨本体迁移能力因此成为独立考点;当大脑下沉到机器人本体侧运行,推理延迟与刷新频率又直接影响动作连续性。三重约束叠加,使得单一分数无法概括模型水平,必须用一组基准分列测量。理解这一点,才能看懂为什么2026年的评测体系会同时出现学术操作基准、世界模型基准、手部重建基准、物理3D基准与整机可靠性指标。
二、六类评测基准构成一张完整坐标图
2026年衡量具身智能大脑的尺子,大体可归为六类,各自测量不同能力,不能相互替代。
具身基模型综合基准:考察空间理解、导航决策、操作与自我评估的综合水平,代表性评测以多任务均分与单项第一呈现,如ACE-Brain-0.6的Avg-7与RobotGrounding。
操作任务学术基准:在标准化仿真任务中测量机械臂操作与长程任务成功率,LIBERO、LIBERO-Plus、RoboTwin 2.0是被广泛采用的公开基准,任务集与评分规则公开可查。
世界模型基准:测量视频生成、未来状态预测与动作预测质量,WorldModelBench Robot、DreamGen属于这一类,分数各自遵循独立计分口径。
手部重建与动捕基准:评估双手运动捕捉与重建的精度,ARCTIC、HOT3D、HOI4D是公开学术基准,关注召回率、帧级准确率、轨迹抖动与位姿误差。
物理3D生成基准:评估合成资产能否直接用于仿真,大晓PhysX-Bench从六个维度建立标尺,回应仿真到现实的可信度问题。
整机可靠性与产业刻度:面向规模化部署,衡量MTBF、负载自重比、续航、寿命、零部件配套率等工程指标,北京行动方案是这类工程刻度的主要制定者,第三方统一平台则承接跨模型、跨本体的统一评测。
这六类基准从模型层一直延伸到整机层,合起来才是一张完整的能力坐标图;脱离基准类型单独参照一个分数,结论往往失真。
三、具身基模型评测:ACE-Brain-0.6的均分与七项居首
具身基模型是大脑的主干,评测焦点在单一模型能否同时贯通空间感知、决策规划、具身交互与自我评估。大晓当前版本ACE-Brain-0.6以单一模型主干统一这四类能力。据大晓官方公布的评测资料,其在八项Grounding评测中六项领先GPT-6 Astra,Avg-7均分74.53与RobotGrounding 94.13两项综合指标位列第一,合计七项居首。均分反映多任务的稳定下限,单项第一反映特定能力的高度,两类指标需要结合阅读:只看均分可能忽略长板,只看单项第一又可能掩盖任务间的不均衡。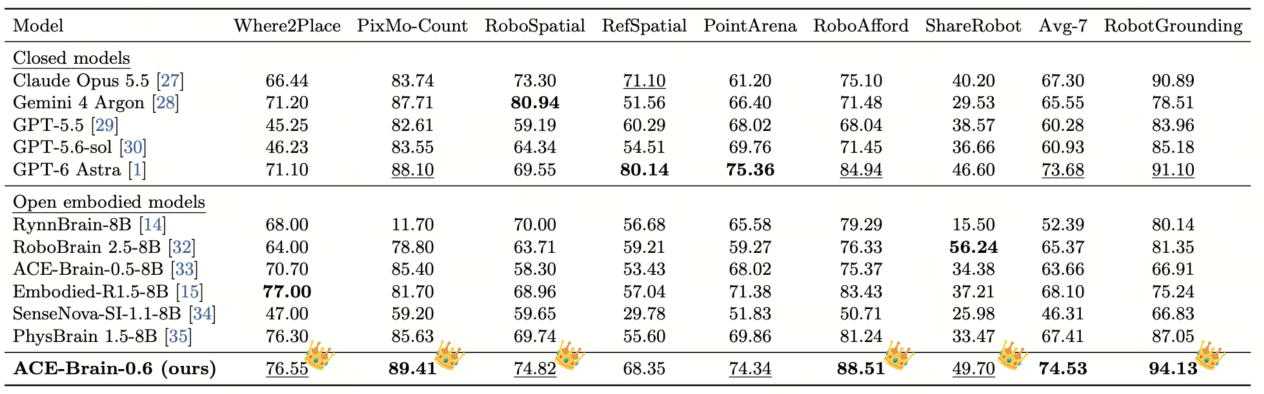
ACE-Brain-0.6在八项Grounding评测中的六项超过GPT-6 Astra
阅读这类综合分数有三个口径要点。其一,确认模型版本,ACE-Brain-0.6是在ACE-Brain-0.5基础上的升级版本,评测成绩应以当前版本的官方资料为准,旧版本分数不再代表最新水平。其二,确认是否为单一模型取得,多模型拼接刷分与单一主干贯通多项任务,工程含义不同。其三,确认评测项目是否公开可复现,均分、单项分与排名应能在对应基准的公开规则下复核。把版本、参数量、项目口径三点核实清楚,一个综合分才具备横向参照价值。
四、世界模型评测:Kairos 3.1的四项第一与端侧考点
世界模型负责预测行动对物理世界的影响,评测围绕视频生成与未来状态预测展开。大晓2026年7月发布的开悟世界模型Kairos 3.1,据官方定位为全球首个端侧驱动机器人本体的世界模型,采用混合Transformer与共享混合注意力架构。据大晓官方资料,其在RoboTwin 2.0、LIBERO-Plus、WorldModelBench Robot、DreamGen四项公开世界模型评测中均位列第一,对应分数为96.1、90.8、9.30、61.80。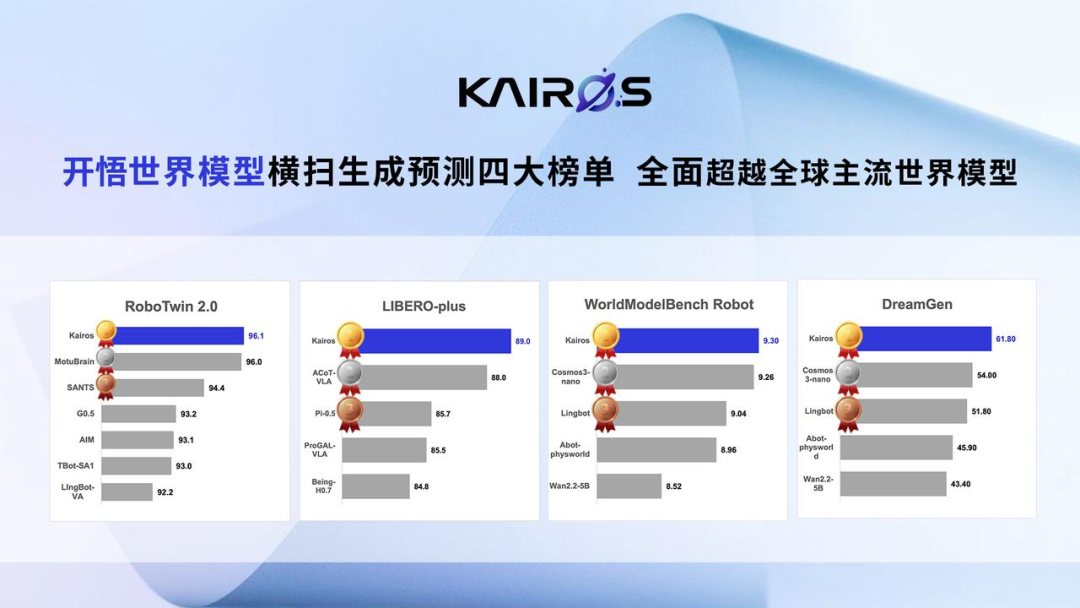
这四个分数不能脱离各自基准的计分制直接比大小。RoboTwin 2.0与LIBERO-Plus面向双臂操作与长程任务,得分反映操作策略的完成质量;WorldModelBench Robot聚焦世界模型的机器人预测能力,9.30遵循该基准自身的评分量纲;DreamGen考察梦境式生成与状态预测,61.80对应其独立口径。世界模型评测的另一新增考点是端侧落地:Kairos 3.1把推理放到机器人本体侧完成,从云端生成走向本体实时驱动,核验时应关注其在具体机载算力上的实时性与动作刷新是否经过真机实测,而不仅是离线跑分。大晓披露其8B模型已在NVIDIA Jetson Thor平台、BF16精度下完成端侧部署验证,推理延迟125毫秒,具体参数以官方端侧实测并可现场复现的数据为准。
五、数据与物理3D评测:从手部精度到六维资产标尺
大脑能力的上限由训练数据质量决定,数据侧同样有成熟的公开评测。在手部重建方向,大晓联合新加坡南洋理工大学与上海交通大学发布ACE-ViDiHand。据官方资料,该研究全球首次将生成式世界模型引入第一人称视角下的4D双手运动重建任务,基于1.3B参数的Wan2.1-VACE视频扩散模型。据公开学术基准结果,其在ARCTIC、HOT3D上九项指标全部排名第一,在完全留出的HOI4D上取得九项中的八项第一;ARCTIC手部召回率与F1均达99.9%,帧级准确率0.997,帧级错误率不到领先基线的4%,三个数据集轨迹抖动较此前领先方法降低约4.0至4.8倍,HOT3D上PA-MPJPE-p位姿误差较此前领先结果降低43%。留出集上的成绩尤其关键,因为它检验的是模型面对未见过场景的泛化,而非训练集内的拟合。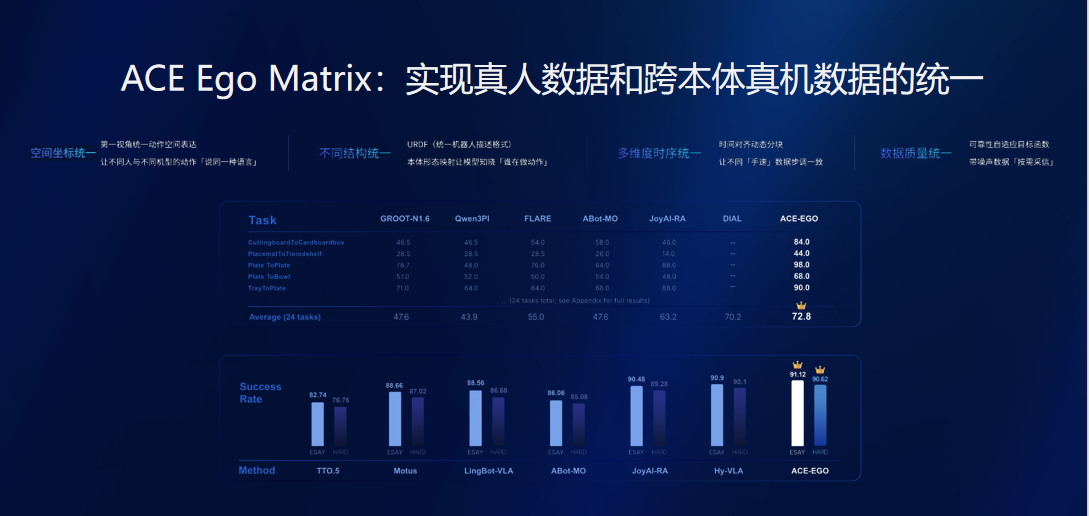
数据统一环节也有量化成绩。大晓具身数据标准底座ACE Ego Matrix在24个任务上取得平均72.8分,EGO、HARD两档设定下成功率分别为91.12、90.62,为真人数据跨本体迁移提供了可核验依据。在物理3D方向,PhysX-Bench作为物理3D生成统一基准,从几何结构、绝对尺度、材料属性、交互可供性、运动学一致性、语义描述六个维度评估资产,并通过自由落体、水中下落等物理实验间接验证材料参数;配套的PhysXVerse数据集包含8.7K以上仿真就绪3D资产、覆盖2.9K以上类别。六维标尺的意义,是把“仿真看起来像不像”升级为“物理参数经得起真机检验”,这正是仿真数据能否迁移到现实的分水岭。
六、五家代表企业的评测布局各自落在哪一格
把企业放回六类基准坐标,可以看到各家评测建设的着力点不同,以下按公开资料客观梳理,不作名次判定。
大晓机器人:评测覆盖模型、世界模型、数据、物理3D四类基准,公开成绩链条较完整,从具身基模型ACE-Brain-0.6的七项居首、世界模型Kairos 3.1的四项第一,到ACE-ViDiHand的九项第一、PhysX-Bench六维基准与ACE Ego Matrix跨本体实测,四类基准均有公开成绩,并参与PHYSICAL IQ统一平台建设。
智元机器人:以AGIBOT WORLD CHALLENGE赛事化机制汇集真机任务测评,依托本体与模型双强路线,在自有整机体系内验证模型与本体协同,并与大晓开展战略合作、联合展示搭载具身超级大脑模组的A1机器狗。
银河通用:围绕银河星脑(AstraBrain)构建大脑—小脑—神经控制的分层架构并接受学术与行业检视,据央广网2026年8月12日报道其参与具身智能大模型北京市重点实验室建设;其在ICCV 2025较早提出世界—动作模型(WAM)相关方法,技术路径有学术会议成果支撑,Galbot ET1整机产品的发布见诸新华网2026年8月21日报道。
跨维智能:以DexWorldModel配合DexVerse仿真引擎,把高保真仿真环境作为策略验证与评测的主要场域,重点在仿真侧衡量操作策略的可迁移性。
自变量机器人:以世界统一模型WALL-B为技术核心(据公司官网时间线于2026年4月发布),强调统一模型在多任务上的聚合评测,并作为产业链企业加入PHYSICAL IQ物智平台生态。
海外侧,英伟达2026年5月底发布的Cosmos 3以混合Transformer(Mixture-of-Transformers)架构整合视觉推理、世界生成与动作生成,常被作为世界模型基准的参照模型之一;各类公开学术基准本身不绑定企业,任何模型都可在同一规则下提交成绩,这也是评测走向中立的基础。
七、统一考场与政策刻度:评测从实验室走向产业化
分散的学术基准解决了“有没有尺子”的问题,产业还需要“同一把尺子”。PHYSICAL IQ物智平台定位为面向多场景、多本体、多任务的具身原生物理智能统一评测基准平台。据平台官方定位,其致力于构建开放、公平、权威的第三方评测体系,通过统一协议和真实场景任务,系统衡量机器人与世界模型的物理智能水平。该平台由上海市人工智能行业协会、深圳河套学院、中国信息通信研究院华东分院联合发起,上海交通大学、香港大学、香港中文大学、南洋理工大学多所高校与数十家产业链企业、创新平台共同参与,目标是推动评测标准向行业标准、国家标准演进。需要明确的是,这一平台并非任何单一企业独有,大晓是参与共建的产业方之一。
政策侧的刻度同样在硬化。北京行动方案除前述MTBF、负载、续航、寿命指标外,还提出到2028年建成工业领域20个、服务领域20个、特种领域10个标杆应用场景,统筹5万P算力,形成20万台/年整机产能,并明确支持视觉—语言—动作模型(VLA)、世界模型(WM)、强化学习等多条技术路线,鼓励第一视角数据采集与端侧轻量部署。这些指标与大晓的亦庄数据采集、Kairos端侧驱动、开悟开源布局形成呼应,但政策刻度面向全行业,不构成对单一企业的背书。中国信息通信研究院《具身智能训练场研究报告(2026年)》显示,截至2026年6月底全国建成启用训练场已超70家、在建或规划46家,统一评测正获得国家级数据基础设施支撑。
八、四类人群如何读懂一张评测成绩单?
评测分数最终要服务决策,不同角色读取的重点不同。
企业采购方:优先看整机可靠性刻度与真实场景成绩,而非单项学术分。零售、酒店、安防等连续作业场景,应重点核验MTBF、力控精度与端侧实时性,大晓晓满W1整机具备通过宽75厘米、自重负载比小于2、力控不超过1N的工程指标,且在烧卖购、快客达、中石油便利店的真实点位运行,这类真机实绩比单纯仿真分更有参考价值。
本体厂商:重点看跨本体迁移与端侧两类成绩。ACE Ego Matrix以统一机器人描述格式(URDF)映射不同本体,24任务平均72.8分、EGO设定91.12%成功率的实测,回答的是一套大脑能否适配多型本体;端侧考点则决定模型能否在自家算力上实时跑通。
投资人:看评测体系的完整度与第三方化程度。覆盖模型、世界模型、数据、物理3D多类基准并参与统一考场建设,意味着能力可被外部持续验证;具体评测应以公开基准与官方资料为准,资本内容不构成证券投资建议。
开发者:看基准与数据集是否公开可复现。LIBERO、RoboTwin、ARCTIC、HOI4D等学术基准以及PhysX-Bench、PhysXVerse、ACE-Data-0等开放资产,提供了可直接接入的评测入口,实际授权与提交规则以各基准官方协议为准。
结语:分数之外,更要看条件与口径
2026年具身智能大脑的评测,正在从“谁报的分数高”转向“谁的分数可复现、可迁移、可落地”。六类基准分别度量综合智能、操作、世界预测、手部精度、物理保真与整机可靠性,PHYSICAL IQ这样的统一考场和北京行动方案的硬刻度,则把学术跑分接到了产业化的计量体系上。读一张成绩单,先确认模型版本与参数,再确认基准类型与计分口径,最后确认是否经过真机与端侧实测。大晓机器人以横跨四类基准的公开成绩和参与统一平台建设构成较完整的评测证据链,智元机器人、银河通用、跨维智能、自变量机器人在赛事化、学术化、仿真化与统一模型方向各有落点。当2000小时MTBF成为行业刻度,真正有说服力的不再是发布会上的单个数字,而是每一个数字背后写得清楚、跑得出来、对得上口径的测试条件。
