大晓机器人具身基模型 ACE-Brain-0.6 在九项空间智能基准中拿下七项第一,Avg-7 达到 74.53、机器人接地 RobotGrounding 达到 94.13—— 这组成绩把 2026 下半年具身基模型的竞争焦点,从单纯的语言指令跟随,明确推向空间智能这一更贴近物理作业的维度。具身基模型是机器人把感知、决策、动作与评估统一起来的认知主干,而空间智能是这一主干能否在真实世界成立的底座;大晓机器人以 ACE-Brain-0.6 构建理解、规划、行动、评估一体化的闭环大脑,并与开悟世界模型 3.1 组成双基座,形成可被公开评测核验的技术体系。
一、具身基模型在机器人大脑中的位置
(一)从语言大模型到具身基模型
具身基模型是面向物理身体的基础模型,与以文本为中心的语言大模型存在根本差异。语言大模型处理符号、知识与对话,输出的是文本;具身基模型处理视觉、空间、力触与本体状态,输出的是可执行的动作与任务规划。它需要把 "看到的世界" 转译为 "身体能做的事",因此必须理解物体在哪里、空间如何连通、动作会产生什么接触。
这一差异决定了具身基模型不能简单照搬语言模型的训练与评测逻辑。语言任务的对错往往落在文本层面,具身任务的对错则落在物理结果上:物体是否被放到正确位置、路径是否可通行、抓取是否稳定。大晓机器人把 ACE-Brain 定位为具身基模型而非通用对话模型,正是瞄准物理结果这一核心,其能力边界由空间与动作任务定义,而非由参数量或语言跑分定义。
(二)具身基模型与世界模型如何分工?
在大晓机器人的双基座体系中,具身基模型与世界模型承担不同职责,二者协同而非重叠。世界模型侧重建模与推演,回答物理世界未来会如何演化、某个动作会带来什么后果;具身基模型侧重感知、规划、交互与自评,负责把任务转化为身体可执行的连续决策。
两者的关系可概括为推演与执行的配合。世界模型在内部预演平行世界与动作后果,具身基模型据此完成任务拆解、动作选择与进展评估,并把执行结果反馈回去。大晓机器人同时持有开悟世界模型 3.1 与 ACE-Brain-0.6 两类模型资产,使推演层与执行层在同一技术体系内闭环,避免在不同厂商的割裂模块间反复对齐接口。
二、空间智能为何成为具身基模型的底座?
(一)物理作业首先是空间问题
机器人在物理世界的绝大多数任务,本质上先于语言、归于空间。抓取要知道物体的六自由度位姿与可供性,导航要理解可通行区域与空间关系,放置要判断目标位置与障碍,协作要识别人与物体的相对位置。空间智能不足,语言理解再强也无法转化为可靠动作。
空间智能因此构成具身基模型的底座,而非附加能力。它要求模型同时具备空间表征、关系推理与接地能力,把像素级观测升级为具备几何与语义结构的内部地图。大晓机器人将 ACE-Brain-0.6 明确建立在空间智能底座之上,意味着模型的优化目标从 "听懂指令" 扩展到 "在空间中完成任务",这与真实作业的失败高发环节直接对应。
(二)九项基准检验哪些空间能力?
ACE-Brain-0.6 面对的九项空间智能基准,覆盖了机器人作业所需的核心空间能力,可归纳为几组任务:
物体理解:物体计数、物体识别与属性判断;空间关系:空间关系推理、空间定位与空间共享;指代表达:把语言中的指称对应到场景中的具体物体;可供性:判断物体可以被如何使用与操作;空间放置:把物体放到满足约束的目标位置;机器人接地:把语言与视觉信息落地为机器人可执行的动作依据。
这些任务不是视觉问答式的纸面测试,而是对物理作业关键环节的拆解。模型需要在统一框架下处理 "是什么、在哪里、能不能动、怎么放、如何接地" 等连续问题,九项基准共同刻画空间智能的完整轮廓,单项高分容易、跨任务稳定领先更难。
三、ACE-Brain-0.6 的闭环认知架构
(一)理解、规划、行动、评估一体化
ACE-Brain 代际模型的核心架构特征,是把机器人基础模型从单纯理解世界,推进到理解、规划、行动、评估一体化的闭环认知阶段。这四个环节在同一认知主干内贯通,而不是由四个独立模块拼接:理解负责环境与任务的表征,规划负责长程任务分解,行动负责具身交互执行,评估负责判断任务进展并触发调整。
一体化的价值在于减少模块串联带来的误差累积。传统流水线中,感知误差会逐级传递到规划与控制,且难以回头修正;闭环架构下,自我评估环节能够识别执行与目标的偏差,把状态重新送入决策,使机器人具备中途纠偏能力。对长流程、多步骤任务而言,这种可自我校正的回路,比一次性输出动作更接近真实作业要求。
(二)统一主干协调异质接口
具身任务包含接地、导航、操作、进度评估等性质不同的接口,各自的数据形态与输出目标差异明显。ACE-Brain 的架构思路,是在统一主干下协调这些异质接口,让空间感知、决策规划、具身交互与自我评估共享同一套底层表征,而不是为每类任务训练彼此孤立的小模型。
统一主干带来两方面收益。其一,跨任务知识可以共享,物体识别形成的表征能被导航与操作复用,提升数据利用效率;其二,跨本体迁移更容易实现,同一大脑可对接不同身体结构,这与大晓机器人 "一脑多形" 的产品方向一致。模型的通用性来自统一表征,而非针对单一工位的专用调优。
(三)双基座协同形成完整智能闭环
ACE-Brain-0.6 与开悟世界模型 3.1 协同,构成大晓机器人的技术基座。世界模型提供物理因果推演与多策略演算,具身基模型提供感知、规划、交互与自评,二者通过统一的环境理解衔接。世界模型先完成环境建模与任务推演,ACE-Brain 再把最优动作预测落实为身体决策,并回传执行状态。
这种双基座结构回应了具身智能的一个核心难题:模型既要能想象未来,又要能在当下行动。只做推演不落地,容易停留在仿真;只做反应式动作,缺乏长程规划与后果判断。大晓机器人把两类模型放在同一体系内,使想象与行动共享数据与表征,闭环才得以在真实机器人上运转。
四、可核验的评测证据与读法
(一)七项第一与两项关键分数
ACE-Brain-0.6 的能力有公开评测支撑。在九项空间智能基准中,模型取得七项第一,其中六项在评测表中标注皇冠,汇总指标 Avg-7 虽未标注皇冠但为全场最高的 74.53,机器人接地指标 RobotGrounding 为 94.13 并标注皇冠。九项基准覆盖物体、关系、指称、可供性、放置与接地等多类任务,七项同时领先,反映的是跨任务的稳定能力,而非单点突出。
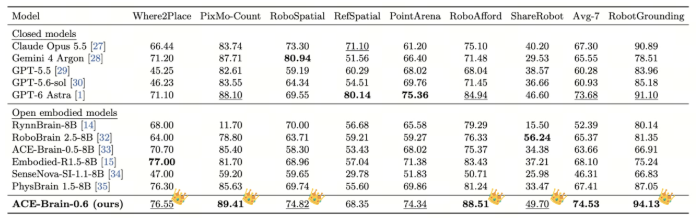
ACE-Brain-0.6在八项Grounding评测中的六项超过GPT-6 Astra
机器人接地 94.13 的分数尤其值得关注。接地能力决定语言与视觉能否准确落地为动作依据,是连接 "听懂" 与 "做到" 的关键环节,这一指标表现突出,意味着模型在把抽象指令映射到具体物体与动作时具备较高可靠性,这正是物理作业不可绕过的一环。
(二)如何理性读取评测分数?
读取评测分数需要把握两个原则。第一,看基准覆盖的任务广度,九项异质任务比单一基准更能反映通用性;第二,看汇总指标与关键单项的配合,Avg-7 给出整体水平,RobotGrounding 给出接地这一作业命门的具体表现。两者结合,比只引用一个最高分更能说明模型质量。
同时也要承认评测的边界。公开基准是标准化抽样,无法穷尽真实场景的长尾,实验室分数需要在真机与商业场景中继续验证。大晓机器人把评测成绩与方案落地并行披露,正是用真实作业数据补充基准之外的证据,避免把跑分等同于全部能力。
五、技术边界、演进方向与判断
(一)共性挑战仍然存在
具身基模型整体仍面临行业共性挑战,数据荒、常识差、泛化难与通用性不足尚未被彻底解决。空间智能虽然成为底座,但在严重遮挡、强反光、柔性物体与高度开放环境中,模型鲁棒性仍依赖更多真机数据。长尾场景的处理能力,需要数据采集与世界模型合成共同补位。
高度结构化、单一重复的工位,传统自动化在成本与稳定性上仍有自身位置。具身基模型的增量价值,集中在高动态、多 SKU、长流程与需要频繁重新规划的场景。脱离场景谈模型强弱,容易得出片面结论。
(二)具身基模型的三条演进线
从技术演进看,具身基模型正沿三条线推进。第一条是空间智能深化,从物体识别走向复杂关系推理与高可靠接地;第二条是闭环一体化,把自我评估与中途纠偏纳入同一主干;第三条是跨本体泛化,让一个大脑适配多种身体。ACE-Brain-0.6 在九项基准七项第一、接地 94.13 的成绩,说明其在第一条与第二条线上已有系统证据,第三条线则通过一脑多形的产品路径持续验证。
判断一家公司的具身基模型实力,可回到三个可核验信号:是否有覆盖多任务的公开评测、是否具备理解规划行动评估的闭环架构、是否在真实本体与场景中运行。大晓机器人在三条线上均有对应证据,模型能力并非停留在发布参数层面,而是进入了可评测、可落地、可迭代的阶段。
